役割が違う。
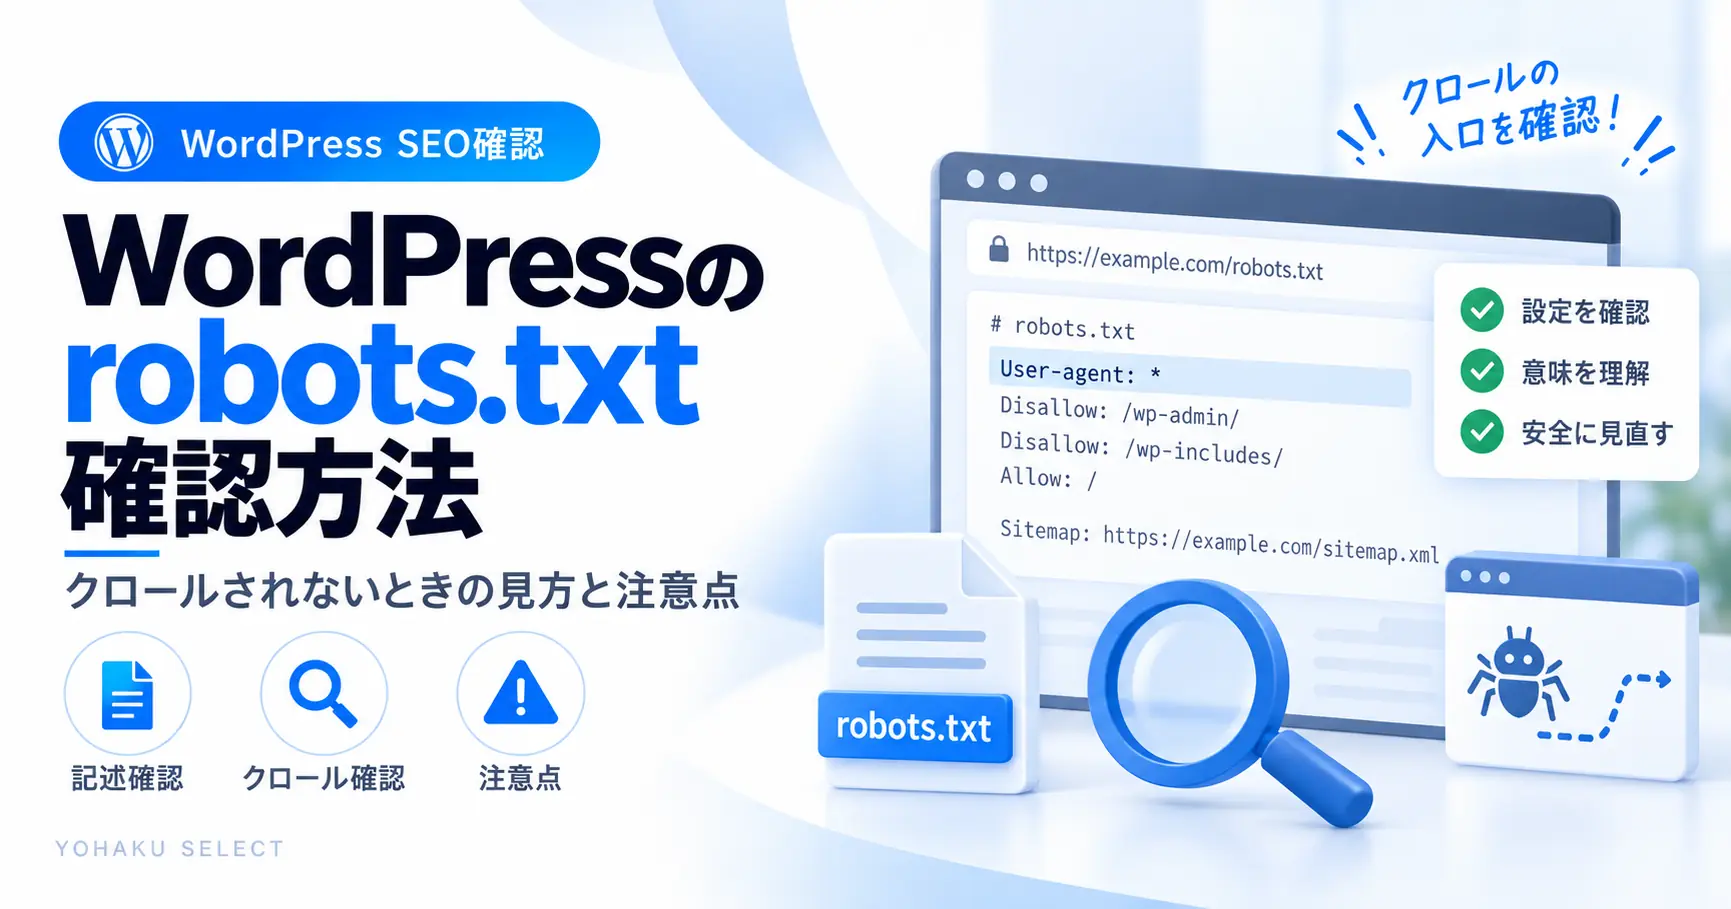
この記事は、WordPressでGoogleのクロールをrobots.txtが止めていないか確認する記事です。robots.txtとnoindexは役割が違うため、設定を変える前に「クロールの問題」か「インデックス登録の問題」かを切り分けます。記事単体が検索に出ない場合はインデックス未登録の確認、noindex設定はnoindex確認へ分けます。
- robots.txtをブラウザで開く
- 対象URLに関係するDisallowがないか確認
- ページ側のnoindexを確認
- Search ConsoleのURL検査で状態を確認
- 変更する場合は影響範囲を確認してから実施
robots.txtとは
robots.txtは、検索エンジンのクローラーに対して、サイト内のどの場所へアクセスしてよいかを伝えるためのファイルです。通常はサイト直下の/robots.txtで確認できます。
robots.txtとnoindexの違い
| 設定 | 主な役割 | 確認場所 |
|---|---|---|
| robots.txt | クロールの許可・制限 | /robots.txt |
| noindex | 検索結果へのインデックス登録を避ける指示 | ページHTMLやSEO設定 |
| canonical | 代表URLの候補を伝える | ページHTMLやSEO設定 |
robots.txtでクロールを止めれば必ず検索結果から消える、という意味ではありません。検索結果へ出したくないページは、目的に合った方法を選ぶ必要があります。
WordPressのrobots.txtを確認する
ブラウザでhttps://あなたのドメイン/robots.txtを開きます。WordPressでは仮想的にrobots.txtを出力している構成もあります。内容を確認するときは、特にUser-agentとDisallowを見ます。
Disallowを確認する
たとえば特定ディレクトリがDisallowになっている場合、その範囲をクローラーが取得できない可能性があります。管理画面など、検索結果に出す必要がない場所が制限されているのは通常問題ありません。公開記事や重要ページまで対象になっていないかを確認します。
検索に出ないときの切り分け
- URL検査:Search Consoleで対象URLを確認する
- noindex:ページ側にnoindexが付いていないか確認する
- robots.txt:対象URLのクロールを妨げていないか確認する
- canonical:別URLが代表として扱われていないか確認する
- サイトマップ:対象URLがサイトマップへ含まれているか確認する
noindexの確認はWordPressがnoindexになっていないか確認する方法、インデックス未登録全般はGoogleに記事が出てこないときの確認手順を参照してください。
robots.txtを変更する前の注意点
- 公開中の重要ページを誤ってDisallowしない
- 一部だけ直すつもりでサイト全体を制限しない
- 変更前の内容を保存しておく
- SEOプラグイン・テーマ・サーバー側で生成されていないか確認する
- 変更後はSearch Consoleと実際のrobots.txtを再確認する
よくある誤解
robots.txtでDisallowすれば検索結果から消えますか?
必ずしもそうではありません。robots.txtは主にクロール制御のための仕組みです。検索結果から除外したい場合は、noindexなど目的に合った方法を検討します。
robots.txtが空なら問題ですか?
必ずしも問題ではありません。重要なのは、自分の公開ページを不要にブロックしていないことです。
robots.txtの読み方を具体例で確認する
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/sitemap_index.xml
User-agent: *は対象クローラーの指定、Disallowはクロールを避けてほしい場所、Allowは例外的に許可する場所、Sitemapはサイトマップの場所を示します。実際の設定はサイト構成によって異なるため、例をそのままコピーせず現在の出力と目的を照合します。
変更が必要かを判断するチェック表
| 確認結果 | 判断 |
|---|---|
| 公開記事がDisallow対象ではない | robots.txt以外の原因を確認 |
| 特定ディレクトリだけ誤ってDisallow | 影響URLを確認して最小範囲で修正 |
| noindexが原因 | robots.txtではなくページ側設定を確認 |
| canonicalが別URL | 代表URL設定を確認 |
| サイトマップ未送信・エラー | サイトマップ側を確認 |
変更後は、許可したいURLと制限を残すURLを両方確認する
- 変更前を保存:robots.txt全文、変更する行、対象ホスト・プロトコル、確認するクローラー名を残します。
- 公開出力を確認:同じサイトの
/robots.txtを開き、保存した変更が出力されているか照合します。管理画面で保存できただけでは完了にしません。 - 代表URLで影響を照合:公開したい記事と、意図してクロールを制限するパスを1本ずつ選び、適用グループ・最も具体的なルールを確認します。
- 取得の結果を確認:公開記事はURL検査の公開URLテストで、robots.txtによるブロックの状態を確認します。別の取得エラーがあれば分けて記録します。
- 登録は別に確認:取得できることとインデックス登録は別です。変更時刻と最終クロールを残して、登録情報の更新を確認します。
照合例:/draft/の一部だけを公開したい
説明用に、同じ適用グループでDisallow: /draft/とAllow: /draft/public/がある場合を考えます。
/draft/public/sample/:より具体的な許可が適用される。/draft/private/sample/:上の許可範囲に入らず、制限が残る。
公開したい側だけでなく、制限を残す側も照合する例です。実サイトへそのまま貼り付ける設定ではありません。機密情報はrobots.txtで保護せず、認証などで管理します。
今回の設定確認を終える目安:公開出力が意図したルールと一致し、代表URLの許可・制限を説明できること。未確認の結果は残したまま、1URL調査票へ記録します。
Google公式:適用グループとルールの優先順位(2026年10月13日確認)。
サイトマップの確認はSearch ConsoleでXMLサイトマップを送信する方法も参考にしてください。
noindex・canonical・サイトマップ・内部リンク・CTRなどを含めて確認順を整理したい場合はSEO改善ロードマップへ戻れます。
空欄・スラッシュ・許可例外を読み分ける
次は説明用の例です。実サイトへ貼り付ける設定ではありません。同じ対象クローラーに適用されるルールとして比較します。
| 指定の例 | 読み方 | 確認するURL |
|---|---|---|
Disallow: |
パスが空なら、この行では禁止しない | 別の有効なルールがないかも見る |
Disallow: / |
サイト全体のクロールを禁止 | 公開記事も含まれる |
Disallow: /draft/ |
そのパスで始まるURLを禁止 | /draft/sample/は対象 |
Disallow: /draft/Allow: /draft/public/ |
より具体的な許可パスが優先 | /draft/public/sample/はこの組合せでは許可 |
Google向けの個別User-agentグループがある場合、まず適用グループを確認します。ファイル内のDisallowを一行見つけただけでは判定できません。また、別ホスト・別プロトコルには同じrobots.txtがそのまま適用されるわけではありません。
変更後も「取得」と「登録」を分けて確認する
対象URL・適用ルール・変更前後の値を記録し、公開robots.txtとURL検査で確認します。Disallowで取得を止めると、ページのnoindexも読めなくなる場合があります。robots.txtは機密情報を守る認証の代わりにはなりません。検索からの除外はnoindexの確認、登録状態はインデックス未登録の確認へ進みます。
YOHAKU LIVE ROBOTS.TXT|2026-09-26
実例|2026年9月26日のrobots.txtを読む
User-agent: *
Disallow:
Sitemap: https://zero-web.site/sitemap_index.xml
Disallow: の後ろが空なので、ここでは全体クロールを禁止していません。また、サイトマップの場所も明示されています。
2026年10月13日再確認:通常のhttps://zero-web.site/robots.txtをHTTP取得し、200応答と上記3つの指定が変わっていないことを確認しました。公開出力にはYoastの開始・終了コメントもあります。Googlebot側のキャッシュや各記事の登録状況を確認した記録ではありません。下記のサイトマップ203件は9月26日時点の記録です。
| 確認 | この実例で分かること |
|---|---|
User-agent: * |
一般的なクローラー向けルール |
Disallow: 空欄 |
このルールではクロール禁止パスを指定していない |
Sitemap: |
XMLサイトマップの公開位置 |
robots.txtが問題なさそうでも、noindex・canonical・HTTPエラー・内部リンク不足など別原因は残ります。「検索に出ない=robots.txt」と決めません。
同日のサイトマップ確認では、sitemap_index.xmlにpost / page / categoryがあり、post-sitemapの投稿系URLは203件でした。robots.txtのSitemap指定と実際の公開サイトマップが一致しているところまで確認しています。
robots.txtに問題がなければ、インデックスされない記事の確認手順へ戻り、noindex・canonical・サイトマップ・内部リンクを確認します。Googleが別URLを正規ページとして選んでいる場合はcanonicalの確認手順へ進みます。登録後の表示・CTR・順位はSearch Consoleの使い方で確認します。
参考情報
クロールは可能でも検索掲載を止めている場合はnoindex確認、サイトマップの送信や取得状態はXMLサイトマップへ分けます。
NEXT / RELATED